Ваши зрители уже пишут вам сценарии в комментариях
Разбор запроса: почему Claude путается на 20 000 комментариев, как устроить базу, которая растёт и не путает, и что из трендвотчинга уже можно отдать ИИ
Главное за минуту
- 20 000 комментариев — это около 1,4 млн токенов. Больше, чем помещается в рабочую память Claude. Он читает кусками и теряет нить — так устроено окно модели.
- Нейросеть не должна читать комментарии. Она должна один раз разметить каждый, а считать и искать будет обычная таблица.
- Разметка миллиона комментариев дешёвой моделью стоит десятки долларов, а не сотни.
- Сырые комментарии, полученные через YouTube API, по правилам YouTube нельзя хранить дольше 30 дней. Копить надо выводы, а не выгрузку.
- Трендвотчинг отдаётся ИИ ровно настолько, насколько вы смогли описать словами, как его делает человек.
В статье: Реальный запрос от контентщика бренда косметики. Почему 20 000 комментариев не влезают в голову нейросети, как устроить таблицу с разметкой вместо папки с файлами, сколько это стоит, какие правила YouTube нужно знать до того, как копить базу, и как передать агенту трендвотчинг.
Содержание11 разделов
- Запрос
- Почему Claude начал путаться
- Нейросеть не должна читать комментарии
- Сколько это стоит
- Нужна ли векторная база и что такое RAG
- Важное про YouTube: копить выводы, а не выгрузку
- Главное — пересечение сигналов
- Как я раскладываю такую систему
- Можно ли отдать трендвотчинг ИИ
- В каком порядке собирать
- Что пока неизвестно
Мне написал человек, который отвечает за контент в бренде косметики для волос. Пишет сценарии, смотрит, что работает в нише, разбирается, о чём говорят клиенты. Мы созвонились, и я понял, что этот запрос надо разобрать публично.
Он типовой. Похожее приносят постоянно, только вместо волос там ремонт, детская одежда или курсы английского. Ниже — без имени и бренда, но со всей логикой: что на самом деле происходит, как устроить систему и в каком порядке её собирать.
Запрос
Человек уже сделал важный шаг: собрал с помощью Claude Code первую выгрузку комментариев по нише с YouTube, сайтов отзывов и форумов. Вышло около 20 000. По ним стало видно, какие ветки набирают больше всего лайков, о чём спорят, что болит. Ролики после этого стали лучше: снимаешь не то, что сам придумал, а то, о чём люди пишут сами.
Дальше Claude предложил подключить YouTube Data API и сказал, что можно собирать до миллиона комментариев в день бесплатно. Человек загорелся: если каждый день по миллиону, какая база будет через полгода.
И тут же споткнулся. Цитирую его: «при анализе 20 тысяч комментариев Claude начал путаться». Отсюда вопросы:
1️⃣ Как поставить сбор на поток, чтобы база пополнялась сама.
2️⃣ Как устроить хранение и анализ, чтобы модель стабильно работала с растущей базой и выдавала идеи для контента.
3️⃣ Можно ли отдать ИИ трендвотчинг. Сейчас его делает ассистентка: листает ленту, собирает залетевшие ролики по категориям (сыворотки, выпадение, рецепты), команда выбирает и переснимает. Ещё она находит рецепты для волос с десятками миллионов просмотров, которые команда потом делает в своём формате. Может ли ИИ сам «смотреть» видео и оценивать?
Начну со второго вопроса. От него зависят оба других.
Почему Claude начал путаться
Claude путался, потому что 20 000 комментариев — около 1,4 миллиона токенов, а его рабочая память — около миллиона.
Посчитаем. Комментарий вместе с метаданными (автор, дата, лайки, ссылка) — в среднем 60–80 токенов. 20 000 комментариев — около 1,4 миллиона токенов. Рабочая память у Claude и большинства флагманских моделей — около миллиона. То есть выгрузка целиком в голову нейросети не помещается. А даже если бы поместилась, работать с ней модель стала бы хуже — об этом ниже.
Что делает Claude Code, когда ему дают папку с такими файлами и говорят «проанализируй»? Не читает всё. Он ищет по файлам ключевые слова, открывает часть, делает выводы по тому, что успел прочитать. Пока рабочая память заполняется, старое сжимается, и детали из начала разговора теряются. Это описано в документации Claude Code, так он устроен.
Но даже когда текст в окно помещается, модель использует его неравномерно. Исследователи давно показали: то, что стоит в начале и в конце длинного текста, модель учитывает лучше, чем середину. Anthropic называет это «гниением контекста»: чем больше в окне, тем хуже точность. Chroma прогнала 18 моделей и увидела то же самое даже на простых задачах.
Отсюда «путаница». Модель честно отвечает по кусочку, который успела увидеть, и уверенно выдаёт его за общую картину. На 200 000 комментариев кусочек станет ещё меньше. На миллионе так работать бессмысленно на любом тарифе.
Попросите аналитика найти главные жалобы клиентов, вывалите ему на стол сто тысяч распечаток и дайте час. Он прочитает пару стопок и сделает вывод. Вывод будет звучать уверенно. И будет про две стопки.
Нейросеть не должна читать комментарии
Модель хороша в одном: прочитать один комментарий и понять, о чём он. Считать, сравнивать и искать по миллиону строк — работа для обычной базы данных. Она делает это быстро, почти бесплатно и каждый раз одинаково.
Поэтому схема другая. Каждый комментарий один раз, в ближайшем суточном прогоне, проходит через модель и получает метки. Дальше вопросы задаются уже таблице.
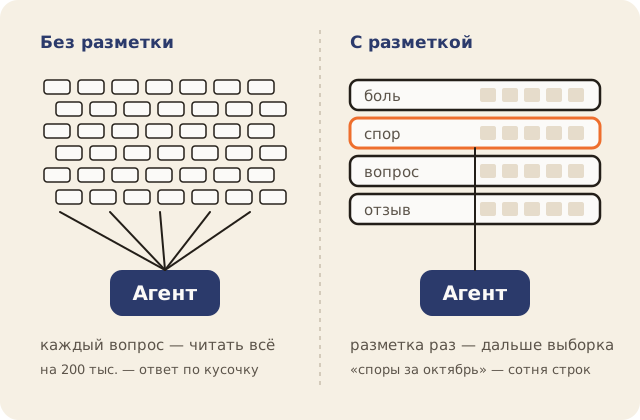
Один комментарий — одна строка таблицы. В строке:
— откуда (площадка, ссылка на ролик или ветку), когда написан, сколько лайков, сколько ответов; — сам текст; — метки, которые поставила модель: тип (боль, вопрос, спор, отзыв о продукте, рецепт), тема из вашего списка, лагерь, если это спор, и короткая формулировка боли своими словами.
Список тем и болей задаёте вы, а не модель. Начните с двадцати-тридцати, которые и так знаете: выпадение после родов, после стресса, недоверие к врачам, миноксидил, сыворотки, витамины. Модель раскладывает по ним и складывает в «другое» всё, что не подошло. Раз в неделю смотрите «другое»: если там копится новая тема, добавляете её в список. Так система учится вместе с вами, и вы всегда видите, по каким правилам она считает.
Теперь вопрос «какие боли выросли за октябрь» — это запрос к таблице. Посчитать, отсортировать, вынуть по десять самых залайканных комментариев на каждую боль. Модель получает на вход сотню нужных строк, а не миллион, и думает над ними. На такой объём её внимания хватает с запасом.
Для старта на одном компьютере хватит SQLite — это база в одном файле, Claude Code работает с ней сам. Когда сбор переедет на сервер и понадобится доступ команде — Postgres, например в Supabase. Просите агента отвечать на вопросы через запросы к базе и сводные таблицы, а не через чтение сырого текста.
Сколько это стоит
Меньше, чем кажется: разметка миллиона комментариев дешёвой моделью обходится примерно в $20–85. Разметка — это тысячи однотипных коротких задач, для неё не нужна самая умная модель. Нужна дешёвая и пакетный режим: запросы отправляются пачкой, ответы приходят в течение суток, а цена — вдвое ниже.
Прикинем на миллион комментариев: на каждый — около 150 токенов на входе (текст плюс инструкция) и 50 на выходе. По ценам на 28 октября 2026 года это:
| Модель | Разметка 1 млн комментариев |
|---|---|
| Claude Haiku 5.5, пакетный режим | около $20 |
| DeepSeek (deepseek-flash), вне пиковых часов | около $50 |
| Gemini 3.5 Flash-Lite, пакетный режим | около $85 |
20 000 комментариев, которые уже собраны, — это меньше доллара. Расчёт мой, цены — с официальных страниц. До запуска на всю базу прогоните 200–300 комментариев и проверьте разметку глазами: качество на русском у моделей разное, и это проверяется только руками.
Отдельный момент с DeepSeek: данные уходят китайскому провайдеру. Для публичных комментариев это обычно не страшно, для данных клиентов — решение за вами.
Нужна ли векторная база и что такое RAG
На старте я бы обошёлся без векторной базы, разметкой по своему списку тем, а RAG — не база, а способ отвечать по нескольким найденным кускам текста.
На созвоне я говорил про векторную базу, эмбеддинги и RAG коротко. Здесь — по порядку, потому что вокруг этих слов много путаницы.
Эмбеддинг — смысловой отпечаток текста, набор чисел. Тексты, близкие по смыслу, получают близкие отпечатки. Поэтому «волосы лезут клоками» и «сильно выпадают после родов» найдутся одним запросом, хотя общих слов у них почти нет. Посчитать отпечатки для миллиона комментариев стоит пару долларов.
Векторная база — место, где хранятся отпечатки и где по ним ищут похожие. Отдельная программа не обязательна: у Postgres есть расширение pgvector, оно добавляет такой поиск прямо в обычную базу. Удобно, потому что рядом лежат дата, площадка и лайки, и можно фильтровать.
RAG — не база, а способ отвечать: найти несколько подходящих кусков и дать модели ответить по ним. Хорош для вопросов вроде «что пишут про наш новый шампунь» или «найди комментарии, похожие на этот». Галлюцинации он снижает, но не отменяет: если поиск принёс не те куски, модель уверенно ответит по ним.
А вот для главной задачи — «топ-100 повторяющихся болей» — RAG не подходит. Он находит десяток похожих кусков, а тут нужно охватить весь массив и посчитать. Это делается разметкой, как выше. Или кластеризацией: отпечатки раскладываются на группы похожих, модель даёт каждой группе название, а размер групп считает код. Для этого есть готовые инструменты, например BERTopic.
На старте я бы обошёлся разметкой по своему списку тем. Она понятнее: вы видите правила и можете их поправить. Отпечатки и поиск похожих добавляются потом, когда база вырастет и захочется находить то, чего нет в списке.
Важное про YouTube: копить выводы, а не выгрузку
Правила YouTube для разработчиков разрешают хранить чужие комментарии не дольше 30 дней, поэтому надолго стоит копить свои выводы, а сырую выгрузку держать скользящим окном.
Когда Claude предлагает «собирать миллион комментариев в день», он обычно не говорит о правилах.
Сама арифметика верная. По документации Google, бесплатная квота YouTube Data API — 10 000 единиц в сутки, страница комментариев (до 100 штук) стоит одну единицу. Отсюда и миллион. Как подключить и не сжечь квоту — расписал по шагам в отдельной статье.
Но у YouTube есть правила для разработчиков, и в них прямо сказано, как долго можно хранить полученные данные. Комментарии чужих роликов, полученные по ключу, можно хранить «временно, в ограниченном объёме» и не дольше 30 дней — потом удалить или обновить. Статистику просмотров — тоже не дольше 30 дней. Ещё один пункт запрещает строить из данных API новые производные метрики. Счётчики по своим меткам вроде «боль выросла вдвое» — как раз такая зона. Для аналитики на потоке у YouTube с 1 июня 2026 года есть отдельный допуск: разработчик проходит аудит и запрашивает право на дополнительные метрики и хранение статистики (раздел III.L правил). Если система становится основой бизнеса, этот аудит стоит пройти.
Я не юрист, и как именно YouTube применяет эти пункты к работе контентщика, судить не берусь. Но строить процесс на «копим сырые комментарии годами» я бы не стал. Как бы делал я:
— сырые комментарии с YouTube живут в базе скользящим окном в 30 дней и обновляются или удаляются; — надолго остаются ваши собственные выводы: «в октябре выросла тема недоверия к анализам», «вот ролик, который это подтвердил», гипотезы команды, отметки сценаристов; — по своему каналу данные смотрите ещё и в YouTube Studio — это ваши данные, к ним другие правила; — у форумов и отзовиков свои условия, читайте их до того, как ставить сбор на поток.
Для задачи «находить темы для роликов» этого хватает. Темы и выводы — главное, что вам нужно. Сырая выгрузка — только сырьё для них.
Главное — пересечение сигналов
Рабочая тема появляется, когда сходятся два сигнала: что залетает в нише и о чём пишут в комментариях.
На созвоне человек рассказал, как у них уже родилась рабочая тема.
Они видели, что в нише залетают ролики про самодиагностику волос. Параллельно в комментариях всплывало недоверие к анализам: людям кажется, что в больнице не могут точно сказать, почему выпадают волосы. Два сигнала сошлись. Команда начала снимать ролики о том, как проверить волосы дома, придумывать новые способы самодиагностики. Ролики залетели.
Ещё пример оттуда же. Под одним роликом пришли сторонники одного средства и начали хейтить. А в собранных комментариях нашлось, что в нише давно воюют два лагеря — условно, «аптечные» и «сывороточники». Следующий ролик напрашивается сам: столкнуть лагеря лбами и дать им поспорить в комментариях.
Ни одну из этих тем не найти простым подсчётом частых слов. Частота покажет «выпадение», «шампунь» и «помогите». Тема рождается на пересечении: о чём спорят или чему не доверяют — и что при этом уже набирает просмотры.
Поэтому в системе нужны два потока. Комментарии по нише — и данные по роликам: чужим залетевшим и своим. И отдельная еженедельная сводка, которая ищет именно пересечения: «эта боль за месяц выросла вдвое, и вот три ролика на эту тему, которые набрали выше обычного».
Как я раскладываю такую систему
Любую подобную систему я раскладываю на одни и те же слои. Даже под одну узкую контентную задачу.
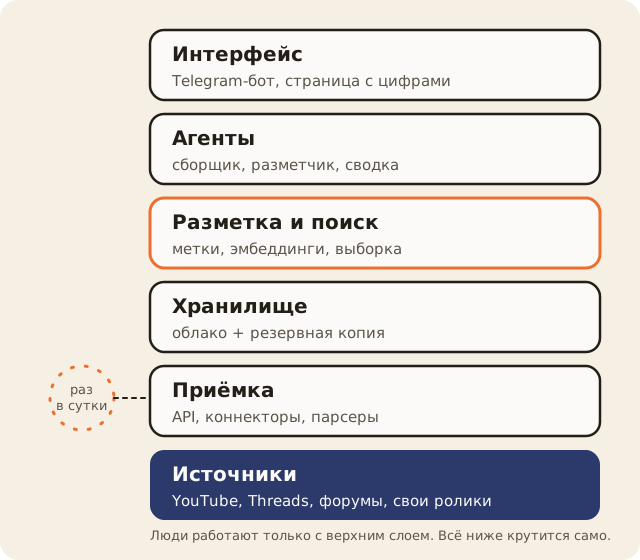
Источники. Не «весь интернет», а конкретный список: YouTube по ключевым словам и каналам, Threads, пара тематических форумов, свои ролики. Плюс место для новых, если окажется, что важное обсуждают где-то ещё.
Приёмка. Кто и как забирает данные из каждого источника: официальный API, готовый коннектор, сервис. Многие форумы и маркетплейсы закрыты от ботов, и ни Claude, ни Codex туда не пустят. Там нужен официальный доступ, партнёрская выгрузка или сервис мониторинга, у которого такой доступ есть. Поэтому каждая лишняя площадка в списке — это деньги и поддержка, а не галочка.
Хранилище. Таблица из предыдущих разделов. Для ежедневного сбора — на сервере или в облаке, не на ноутбуке: сбор должен идти, когда ноутбук закрыт. И с резервной копией.
Разметка. Дешёвая модель в пакетном режиме, раз в сутки, по вашему списку тем.
Агенты и сводки. Еженедельная сводка «что нового и что пересекается», мониторинг своих роликов, отбор роликов для трендвотчинга.
Интерфейс. Через что этим пользуются люди. Сценаристу и ассистентке удобнее всего Telegram-бот: пришла подборка, отметил, что берёшь, попросил ещё. Руководителю — страница с цифрами.
Запускать по расписанию можно по-разному. В Claude Code есть запланированные задачи: облачные работают без вашего компьютера (не чаще раза в час), локальные — пока компьютер включён. Для простого ежедневного сбора хватит обычного расписания на недорогом сервере: агент один раз пишет скрипт и ставит его, дальше сбор идёт без токенов.
Код агент напишет сам. Дольше всего — решить словами, откуда, что и в каком виде собираем и что потом с этим делаем.
Можно ли отдать трендвотчинг ИИ
Короткий ответ: частично — и прямо сейчас.
Что ИИ уже делает нормально:
— находит ролики по каналам и ключевым словам и отсеивает по порогу (например, от 20 тысяч просмотров — это пример, порог у каждой ниши свой); — собирает к каждому просмотры, дату, лучшие комментарии; — раскладывает по вашим категориям: сыворотки, выпадение, рецепты; — «смотрит» видео. Gemini принимает ссылку на публичный ролик YouTube и может рассказать, что в нём показывают и о чём говорят. Claude видео напрямую не принимает: ему нужны кадры и расшифровка звука.
Что пока плохо без человека — вкус. «Это наше, а это нет» ассистентка, которая давно в нише, решает за секунду и обычно не может объяснить, как. В этом вся загвоздка.
Человек уже попробовал: Claude через vidIQ (у сервиса есть официальное подключение к ИИ-ассистентам) сделал три поиска и собрал пачку роликов. Часть попала, но ассистентка собирает чище. Это нормальный результат первого прогона. Агенту никто не объяснил, что такое «наше».
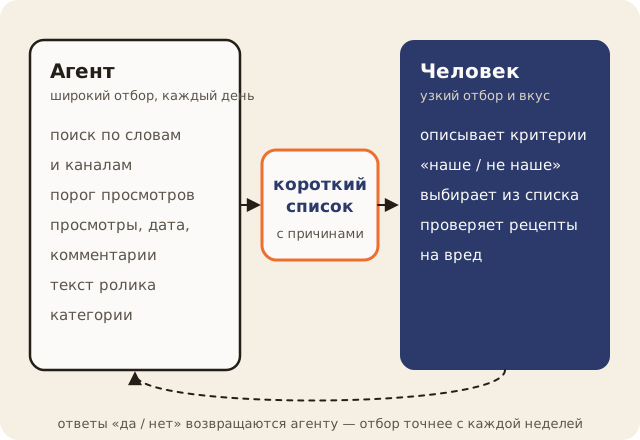
Как объяснить. Я начинаю всегда одинаково: представьте, что к вам пришёл новый сотрудник, и вы объясняете ему работу по шагам. Вот каналы, вот ссылки. Идёшь сюда, собираешь вот это. «Залетевший» — это сколько? За какой срок? Только эти три профиля смотришь — или ещё как-то ищешь? «А, ещё вот так ищу». Агент не понимает ровно те же места, что не понял бы новенький.
Лучше всего записать, как ассистентка работает: экран и голос, полчаса обычного трендвотчинга. По такой записи агент соберёт инструкцию точнее, чем по любому пересказу. Шаблон для описания — в конце статьи.
Дальше схема простая. Агент каждый день делает широкий отбор и присылает короткий список с объяснением, почему каждый ролик туда попал. Ассистентка выбирает из него, а не листает ленту. Её «да» и «нет» записываются, и через месяц у агента сотни примеров «наше / не наше». Отбор становится точнее, а на работу уходит полчаса вместо полдня.
С вирусными рецептами так же, с одной оговоркой. Ниша рядом с медициной: рецепт с десятками миллионов просмотров может оказаться вредным. Найти такие рецепты агент поможет. Решать, брать ли рецепт в работу от имени бренда, я бы оставил человеку. И ещё права: чужой ролик остаётся чужим, даже если пересказать его своими словами и своим голосом.
В каком порядке собирать
Человек сам сформулировал правильно: сначала простой автомат «на картошке», потом наращивать. Сценарии при этом пишут люди — система нужна, чтобы находить и подтверждать темы. Я бы шёл так.
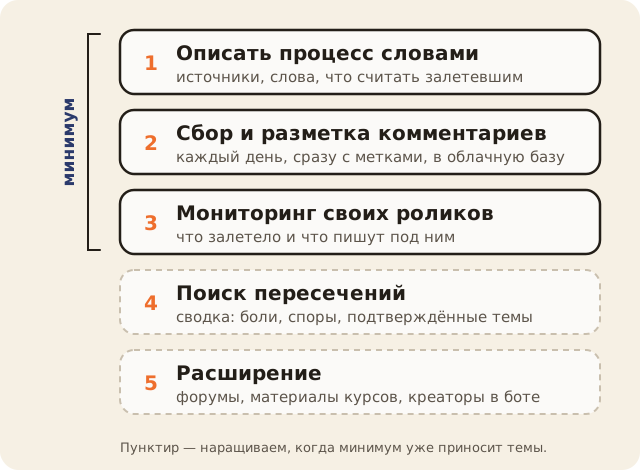
1️⃣ Описать процесс словами. Источники, ключевые слова, каналы, что считать залетевшим, список тем и болей. Без этого всё остальное — гадание.
2️⃣ Сбор и разметка комментариев. Каждый день, по списку источников, в таблицу — и сразу с метками. Разметку не откладываю: именно она спасает от путаницы.
3️⃣ Мониторинг своих роликов. Выпустили пачку, через несколько дней агент сам смотрит, что залетело и что пишут под этими роликами.
4️⃣ Поиск пересечений. Еженедельная сводка: новые боли, споры, темы, которые подтверждаются просмотрами.
5️⃣ Расширение. Форумы, материалы собственных курсов бренда, потом креаторы. У бренда их десятки. Если в базе есть, у кого что лучше получается, бот может каждому присылать свою подборку тем: отметь, что берёшь.
Про материалы курсов отдельно — это недооценённая вещь. Недавно мы для одной онлайн-школы собрали базу знаний из примерно 170 видеоуроков и книги автора на несколько сотен страниц. Теперь агент берёт подходы и формулировки оттуда, а не придумывает свои. Для бренда это значит, что сценарии опираются на его методику, а не на общее «ешьте витамины».
Чего я бы не делал на первом шаге: собирать «со всего интернета», строить сразу команду из десятка агентов и поручать нейросети сценарии. Был у меня запрос: «хочу трендвотчинг со всего интернета, сценарии, ролики и публикацию под ключ, 9 000 роликов в месяц». Посчитали — вышло 7,5 миллиона рублей разработки. «Весь интернет» столько и стоит, поэтому начинать стоит с пары источников.
Что пока неизвестно
Это разбор до внедрения, цифр по результату пока нет. Неизвестно, сколько будет стоить сбор с форумов этой ниши — зависит от площадок. Неизвестно, какой порог «залетевшего» окажется правильным для этого бренда — подбирается по первым неделям. И неизвестно, как быстро агент научится отбирать ролики так же, как ассистентка: это покажет месяц её «да» и «нет».
Когда появятся цифры, обновлю этот текст.
Описание процесса для агента
Когда пользоваться: Перед тем как отдавать агенту ручную работу — трендвотчинг, сбор комментариев, отбор роликов
Процесс: [как называется, например «поиск залетевших роликов в нише»] Кто делает сейчас: [роль] · сколько времени в неделю: [часы]
- Где ищет: [площадки, каналы, ссылки, поисковые запросы — списком]
- Что считает подходящим: [порог просмотров, давность, формат, тема — числами, где можно]
- Что отбрасывает сразу и почему: [3–5 примеров]
- Что сохраняет о каждой находке: [ссылка, просмотры, дата, тема, лучшие комментарии, о чём ролик]
- Куда кладёт и кому отдаёт: [таблица, папка, чат; кто дальше решает]
- Как понять, что работа сделана хорошо: [например: из 20 найденных в работу берут хотя бы 5]
- Три примера «точно наше» и три «точно не наше» — со ссылками и одной фразой, почему.
Задание агенту: прочитай описание. Задай мне вопросы по каждому месту, где новый сотрудник не понял бы, что делать. Только после ответов предложи, что автоматизировать, что останется человеку и как мы проверим, что агент отбирает не хуже.
Процесс: [как называется, например «поиск залетевших роликов в нише»]
Кто делает сейчас: [роль] · сколько времени в неделю: [часы]

1. Где ищет: [площадки, каналы, ссылки, поисковые запросы — списком]
2. Что считает подходящим: [порог просмотров, давность, формат, тема — числами, где можно]
3. Что отбрасывает сразу и почему: [3–5 примеров]
4. Что сохраняет о каждой находке: [ссылка, просмотры, дата, тема, лучшие комментарии, о чём ролик]
5. Куда кладёт и кому отдаёт: [таблица, папка, чат; кто дальше решает]
6. Как понять, что работа сделана хорошо: [например: из 20 найденных в работу берут хотя бы 5]
7. Три примера «точно наше» и три «точно не наше» — со ссылками и одной фразой, почему.

Задание агенту: прочитай описание. Задай мне вопросы по каждому месту, где новый сотрудник не понял бы, что делать. Только после ответов предложи, что автоматизировать, что останется человеку и как мы проверим, что агент отбирает не хуже.
Разобрать с ИИ
Готовый промпт со ссылкой на материал: пересказ, главные выводы и как применить к вашей задаче.
Посмотреть промпт
Вам может быть интересно
 ИИ-агент простыми словами: обычная модель, которой обустроили рабочее местоПолная версия гайда «ИИ-агенты без магии»: Model, Harness, Loop, Evals и Graph по-человечески, готовые файлы для Codex и Claude Code и план первой недели
 ИИ-агенты на практике: работу за 70 000 ₽ в месяц забрали агенты, осталась проверкаОдна цепочка: как разбор урока, на который уходило два-три часа, стал делаться без человека посередине
 Чем чат отличается от агента: первое занятие НЕЙРОЛОГИКИ 8.0Сокращённая запись установочного созвона восьмого потока: 44 минуты без организационных моментов и живой показ — пять агентов параллельно работают над сайтом нового клиента
 Вайбкодинг лучше всего тренировать на собственной болиКак я за неделю собрал через Codex приложение для пересылки сторис и упёрся в политику VK на последнем метре
 72 ГБ рабочих материалов агент разобрал за три часа моего времениКак я с Codex навёл порядок в 106 тысячах файлов и почему это хороший первый сценарий для ИИ-агента
 Бэкапы по правилу 3-2-1-1-0: что я понял, когда упал БегетРазбор по горячим следам атаки на Бегет 2 ноября 2026: что такое настоящая резервная копия и что у меня уцелело. Отдельно — путь для тех, у кого сайт делал подрядчик, и для тех, кто работает с агентом
 GitHub с нуля: что это такое и как подключить его к ИИ-агентуДля тех, кто работает с Codex или Claude Code и ни разу не открывал GitHub: восемь понятий, регистрация и один запрос (после него агент сам сделает приватную копию вашей папки). Для тех, у кого есть подрядчик или команда, — правила доступа
 Claude Code: как пользоваться агентом, который сам работает с вашими файламиУстановка, первая сессия, режимы разрешений, CLAUDE.md и AGENTS.md, навыки, субагенты, хуки и MCP — и честное сравнение с Codex. Всё сверено с документацией на 27 октября 2026
 Как писать промпты для нейросетей: постановка задачи вместо заклинанийИз чего состоит хороший промпт, какие старые приёмы пора выбросить, примеры «было → стало» и готовые промпты для копирования
 Нейросети для работы: хватит одной-двух, если знать, что им поручатьСемь ассистентов на октябрь 2026 года: что каждый делает лучше, что бесплатно, что работает из России. Карта «задача → инструмент» по профессиям, 152-ФЗ коротко, план первой недели и рабочие промпты
Источники · 14
- Запрос клиента в Telegram и созвон 28.10.2026; клиент обезличен, публикация примеров согласована
- Anthropic: размер контекстного окна и деградация на длинном контексте (context rot)
- Liu и соавторы, «Lost in the Middle»: модели хуже используют информацию из середины длинного текста
- Chroma: исследование деградации 18 моделей на длинном входе
- Как Claude Code работает с файлами и контекстом
- Цены Claude API, в том числе Batch API со скидкой 50 % (28.10.2026)
- Цена эмбеддингов OpenAI text-embedding-3-small (28.10.2026)
- pgvector — векторный поиск внутри Postgres
- BERTopic — поиск тем в большом массиве текстов
- Квоты YouTube Data API (28.10.2026)
- YouTube API Services Developer Policies, раздел III.E.4 — хранение данных (редакция 15.10.2026)
- Gemini API: понимание видео и YouTube-ссылки
- vidIQ MCP — официальное подключение vidIQ к ИИ-ассистентам
- Запланированные задачи в Claude Code