Как научить агента собирать комментарии с YouTube каждый день
Пошагово: ключ YouTube Data API за 15 минут, промпт для Claude Code или Codex, расчёт квоты и правила, о которых агент обычно не предупреждает
Главное за минуту
- Для чтения публичных комментариев хватает API-ключа: без OAuth, без программиста, минут за пятнадцать.
- Бесплатная квота — 10 000 единиц в сутки. Страница из 100 комментариев стоит одну единицу.
- Поиск ограничен сотней запросов в сутки, поэтому знакомые каналы берите списком: их свежие ролики достаются за одну единицу квоты.
- Сырые данные из API по правилам YouTube нельзя хранить дольше 30 дней. Храните выводы, а выгрузку обновляйте.
В статье: Как подключить официальный YouTube Data API к своему ИИ-агенту: создать проект в Google Cloud, включить API, получить и ограничить ключ, безопасно отдать его агенту, собрать первые комментарии, посчитать квоту и поставить сбор на расписание. Плюс ограничения: ответы на комментарии, субтитры, правило 30 дней.
Содержание10 разделов
Эта статья выросла из разбора одного запроса: контентщик бренда косметики собрал 20 000 комментариев и захотел собирать их каждый день. Claude ему сказал: подключи YouTube Data API, и будет до миллиона комментариев в сутки бесплатно.
Это правда. Мы прошли этот путь на живом аккаунте 28 октября 2026 года: создали проект, ключ и сделали пробные запросы. По дороге есть пять мест, где люди спотыкаются: ключ, который отдают агенту небезопасно, поиск, которого всего 100 запросов в сутки, ответы на комментарии, которые приходят не все, субтитры, которых API не отдаёт, и правило про хранение данных, о котором агент обычно молчит. Ниже — весь путь по шагам.
Что получится в конце: агент раз в сутки сам забирает свежие ролики по вашему списку каналов и ключевых слов, достаёт к ним комментарии и складывает в таблицу без дублей. Вам остаётся читать сводки.
Что понадобится: Google-аккаунт, минут пятнадцать и Claude Code или Codex. Программировать не нужно, код напишет агент.
Шаг 1. Проект в Google Cloud
Откройте console.cloud.google.com и войдите своим Google-аккаунтом. Проще всего создать проект по прямой ссылке. Или нажмите выбор проекта наверху рядом с логотипом и затем New project («Новый проект»). Дайте понятное имя, например youtube-comments, и нажмите Create.
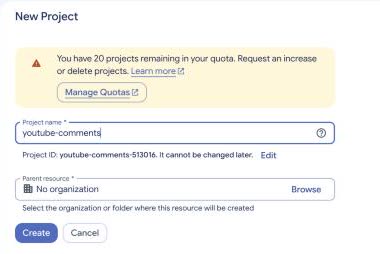
Проект — это папка, к которой привязаны ключ и квота. Если будете собирать для разных брендов, заведите на каждый свой проект: так квоты не смешиваются.
Платёжная карта не нужна. Мы проходили этот путь на обычном аккаунте 28 октября, и ни на одном шаге Google её не спросил.
Шаг 2. Включить YouTube Data API v3
Откройте карточку API по прямой ссылке или через меню: APIs & Services → Library, в поиске — YouTube Data API v3. Проверьте, что наверху выбран ваш новый проект, и нажмите Enable.
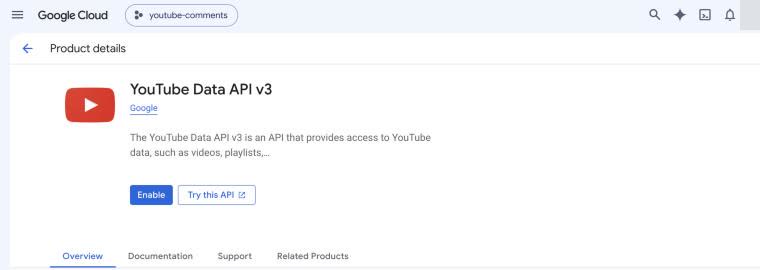
Через несколько секунд откроется страница API со статусом Enabled. Здесь же потом будут вкладки Metrics (сколько запросов ушло) и Quotas & System Limits (сколько осталось).
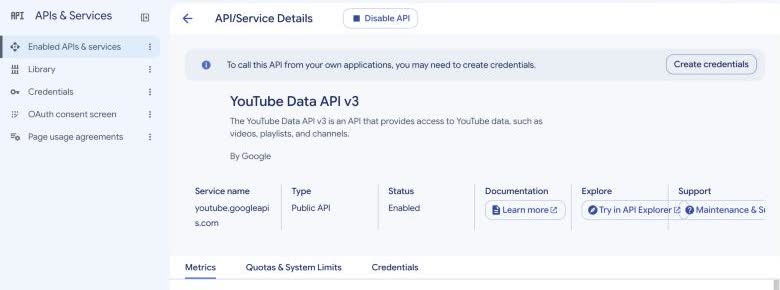
Шаг 3. Создать ключ и сразу его ограничить
APIs & Services → Credentials → Create credentials → API key.
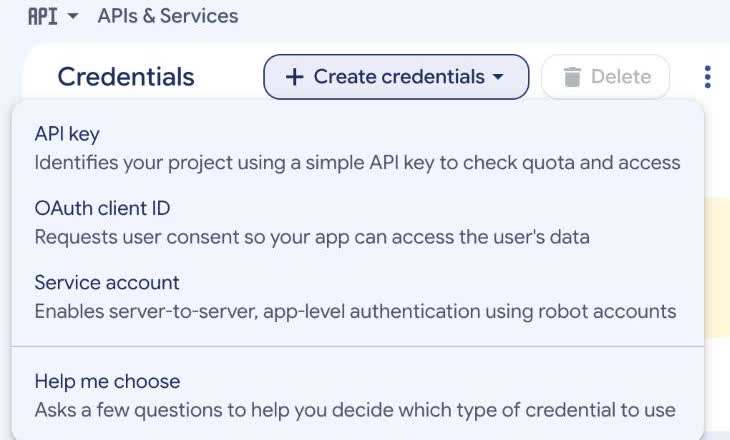
Откроется окно создания ключа. Сейчас окно устроено так: ограничение по API выбирается прямо при создании, и без него ключ не создать. Заполните два поля:
— Name — понятное имя, например youtube-comments-agent; — Select API restrictions — откройте список и отметьте только YouTube Data API v3. В списке лишь те API, которые включены в проекте, поэтому шаг 2 нужен раньше.
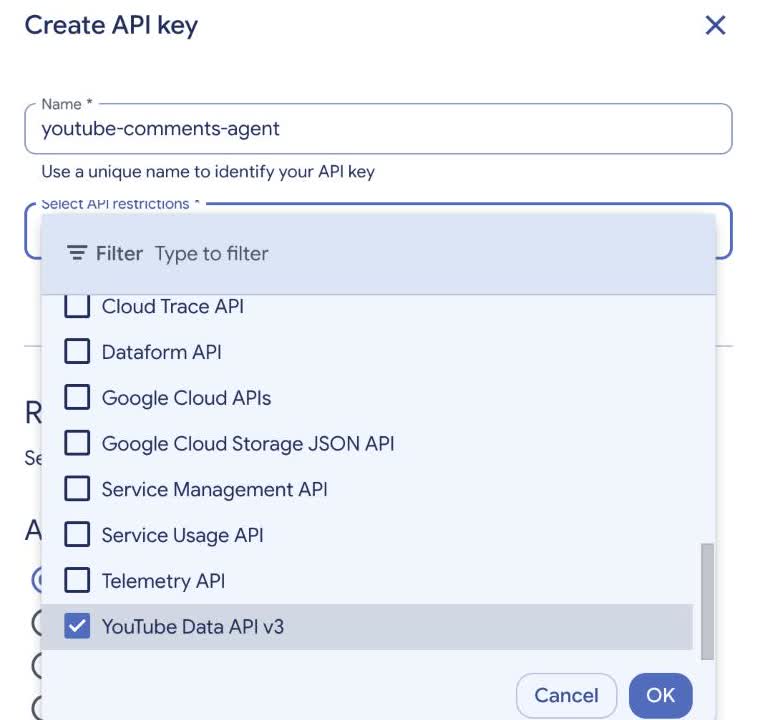
Application restrictions оставьте пока None. Ограничение по IP-адресу имеет смысл добавить, когда сбор переедет на сервер с постоянным адресом.
Нажмите Create. Появится окно API key created, в нём ключ — строка из 39 символов, начинается с AIza. Скопируйте его значком рядом и сразу переходите к шагу 4.
Для чтения публичных данных — комментариев, просмотров, списка роликов канала — ключа достаточно. Вход через аккаунт (OAuth) нужен, только если агент будет что-то менять на канале или читать закрытую статистику своего канала.
Шаг 4. Отдать ключ агенту безопасно
Не вставляйте ключ в чат с агентом и в общие документы. Всё, что попало в чат, остаётся в журнале сессии. В папке проекта создайте файл .env и положите туда одну строку:
YOUTUBE_API_KEY=ваш_ключАгенту достаточно сказать, что ключ лежит в .env в переменной YOUTUBE_API_KEY. И попросить добавить .env в .gitignore, чтобы ключ не уехал в репозиторий. Если у вас есть менеджер паролей или системная связка ключей, ещё лучше хранить ключ там, а агенту отдавать только имя.
Шаг 5. Первый запрос
Чтобы увидеть, что всё работает, хватит одного запроса. Вот как выглядит просьба отдать комментарии одного ролика:
https://www.googleapis.com/youtube/v3/commentThreads?part=snippet,replies&videoId=ID_РОЛИКА&maxResults=100&order=relevance&textFormat=plainText&key=ВАШ_КЛЮЧID ролика — это кусок ссылки после watch?v= (у Shorts — после /shorts/). В ответ придёт до 100 веток с текстом, автором, датой, лайками и числом ответов. С Shorts работает так же: в пробном запуске мы взяли 57-секундный ролик по запросу «выпадение волос», и комментарии пришли тем же запросом. Руками это делать не нужно, но полезно один раз понимать, что агент делает под капотом. Аккуратный агент вообще передаёт ключ не в адресе, а в заголовке запроса — так он не оседает в логах.
Дальше дайте агенту промпт из блока «Взять с собой» в конце статьи. Он попросит его сначала показать план и расход квоты, потом сделать пробный запуск на трёх роликах. Не пропускайте пробный запуск: на нём видно, собирается ли вообще то, что нужно.
Квота: откуда миллион и как его не сжечь
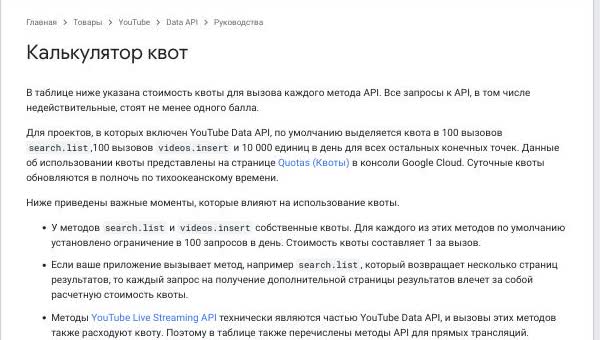
Бесплатно каждый проект получает 10 000 единиц в сутки. Почти любой запрос на чтение стоит одну единицу: страница комментариев (до 100 штук), список роликов канала (до 50), статистика по пачке роликов. Отсюда и миллион: 10 000 страниц по 100 комментариев.
Поиск устроен отдельно: 100 запросов в сутки. Оба лимита видно у себя в консоли, на вкладке Quotas & System Limits: Queries per day — 10 000, Search Queries per day — 100. Один поиск возвращает до 50 роликов. Квота обновляется в полночь по тихоокеанскому времени — это 10 утра по Москве, а после перехода США на зимнее время (со 2 ноября) — 11 утра.
Главный приём — не искать там, где можно взять список. Если вы знаете каналы конкурентов и блогеров ниши, их свежие ролики достаются почти даром: у каждого канала есть плейлист «все загрузки», и чтение его страницы стоит одну единицу. Поиск по ключевым словам оставьте на то, чего вы не знаете: новые каналы, случайные залётные ролики.
Прикинем типичный день. 30 каналов в списке — 30 единиц на проверку свежих роликов. Статистика по ним — ещё несколько единиц. Комментарии к 50 роликам по 5 страниц — 250 единиц. 20 поисков по ключевым словам — отдельный лимит. Итого меньше 300 единиц из 10 000. Квоты хватит с огромным запасом. Упрётесь вы скорее в то, сколько комментариев успеете осмыслить, а не в лимит Google.
Если квоты всё же не хватит, её можно увеличить, но через аудит: Google проверит, что проект соблюдает правила. Форма — в разделе про аудит и квоты.
Что API не отдаёт
Ответы на комментарии — не все. К ветке приходит только часть ответов. В нашем пробном запуске у самой обсуждаемой ветки было 21 ответ, а вместе с веткой пришло пять. Остальные 16 вернул отдельный запрос по ID ветки (parentId). Если ответов много (а в спорах их много, и там самое интересное), агент должен отдельно запросить их по ID ветки. Это есть в промпте.
Субтитры чужих роликов. Официально скачать субтитры через API может только тот, у кого есть право редактировать ролик. Для чужих видео текст придётся получать иначе. Самый простой путь сейчас — Gemini: он принимает ссылку на публичный ролик YouTube и может пересказать, что в нём говорят и показывают. Есть и сервисы аналитики со своими подключениями к агентам, например vidIQ.
Комментарии, где они отключены. Агент получит ошибку commentsDisabled. Это нормально: пропустить и идти дальше.
Правило 30 дней
У YouTube есть правила для разработчиков, и в разделе о хранении данных сказано: данные, полученные без авторизации владельца (то есть по ключу), можно хранить «временно, в ограниченном объёме» и не дольше 30 календарных дней. Потом — удалить или обновить. Статистику просмотров и подписчиков чужих каналов — тоже не дольше 30 дней.
Там же есть запрет строить из этих данных новые метрики; для аналитики на потоке с 1 июня 2026 года есть отдельный допуск через аудит (раздел III.L). Подробнее — в разборе запроса. На практике я делаю так:
— сырые комментарии живут в базе скользящим окном: старше 30 дней — обновить или удалить (агент делает это сам, это есть в промпте); — надолго остаются ваши выводы: какие темы растут, какие ролики их подтвердили, гипотезы и пометки команды; — не передавайте выгрузку дальше: правила не дают вам прав на эти данные.
Как превращать собранное в темы, а не в свалку, — тоже в разборе.
Как поставить на расписание
Когда пробный запуск прошёл, сбор надо запускать без вас. Варианта три.
Запланированные задачи Claude Code. Облачные работают без вашего компьютера, но не чаще раза в час и видят только репозиторий, а не локальные файлы. Локальные видят файлы, но работают, пока компьютер включён. Минус: каждый запуск тратит токены.
Расписание на сервере. Агент пишет скрипт один раз и ставит его на ежедневный запуск на недорогом сервере. Дальше сбор идёт без нейросети и без токенов. Для ежедневной рутины — мой выбор.
GitHub Actions. Бесплатное расписание при репозитории на GitHub. Учтите: в публичном репозитории расписание отключается после 60 дней без изменений, а в начале часа запуск может задерживаться.
В облаке и в GitHub Actions нет вашего .env и локальной базы: ключ кладётся в секреты сервиса, база — во внешнее хранилище. Публичный репозиторий для базы комментариев не годится.
В любом варианте попросите агента присылать отчёт после запуска: сколько собрано, сколько квоты ушло, какие ошибки. Если сбор молча упал неделю назад, лучше узнать об этом из сообщения, а не из пустой базы.
А готовые подключения есть?
На 28 октября 2026 года официального MCP-сервера для YouTube Data API у Google я не нашёл. На GitHub лежит несколько сторонних MCP-серверов, которые умеют доставать комментарии по ключу. Пользоваться можно, но код чужого сервера стоит посмотреть до установки — через него проходит ваш ключ. У vidIQ есть официальный MCP: подключается к Claude и другим ассистентам, умеет анализировать каналы, ролики и комментарии, расходует кредиты сервиса.
Для ежедневного сбора в свою базу я бы не брал готовый сервер, а попросил агента написать маленький скрипт по промпту ниже. Он ваш, понятен целиком и ничего лишнего не делает.
Промпт: ежедневный сбор комментариев с YouTube
Когда пользоваться: Когда ключ уже получен и лежит в файле .env — отдать агенту в Claude Code или Codex
Задача: собрать систему ежедневного сбора комментариев с YouTube через официальный YouTube Data API v3.

Ключ лежит в файле .env в переменной YOUTUBE_API_KEY. Не выводи его в чат и в логи, добавь .env в .gitignore.

Что собирать:
- каналы из файла channels.txt (по одному @handle в строке): свежие ролики за последние [7] дней через uploads-плейлист канала (channels.list → playlistItems.list), без search.list;
- ролики по ключевым словам из файла keywords.txt через search.list — не больше [20] запросов в сутки;
- для каждого ролика: название, дата, просмотры, лайки, число комментариев (videos.list);
- комментарии (commentThreads.list, part=snippet,replies, order=relevance, textFormat=plainText, до [5] страниц на ролик) и все ответы к веткам, где ответов больше, чем пришло вместе с веткой (comments.list с parentId).

Где хранить: SQLite-файл comments.db. Один комментарий — одна строка: id, video_id, ссылка, автор, текст, лайки, число ответов, дата публикации, дата сбора. Без дублей: повторный сбор обновляет лайки и дописывает новое.

Правила:
- считай расход квоты и останавливайся на [8 000] единиц в сутки;
- удаляй или обновляй строки старше 30 дней (правила YouTube API Services, раздел III.E.4);
- если у ролика отключены комментарии — пропусти и запиши в лог;
- в конце каждого запуска — короткий отчёт: сколько роликов, сколько новых комментариев, сколько единиц квоты, какие ошибки.

Сначала покажи план и оценку расхода квоты на мои списки. Потом сделай пробный запуск на 3 роликах и покажи 10 строк из базы. Расписание ставь только после моего «ок».
Задача: собрать систему ежедневного сбора комментариев с YouTube через официальный YouTube Data API v3. Ключ лежит в файле .env в переменной YOUTUBE_API_KEY. Не выводи его в чат и в логи, добавь .env в .gitignore. Что собирать: - каналы из файла channels.txt (по одному @handle в строке): свежие ролики за последние [7] дней через uploads-плейлист канала (channels.list → playlistItems.list), без search.list; - ролики по ключевым словам из файла keywords.txt через search.list — не больше [20] запросов в сутки; - для каждого ролика: название, дата, просмотры, лайки, число комментариев (videos.list); - комментарии (commentThreads.list, part=snippet,replies, order=relevance, textFormat=plainText, до [5] страниц на ролик) и все ответы к веткам, где ответов больше, чем пришло вместе с веткой (comments.list с parentId). Где хранить: SQLite-файл comments.db. Один комментарий — одна строка: id, video_id, ссылка, автор, текст, лайки, число ответов, дата публикации, дата сбора. Без дублей: повторный сбор обновляет лайки и дописывает новое. Правила: - считай расход квоты и останавливайся на [8 000] единиц в сутки; - удаляй или обновляй строки старше 30 дней (правила YouTube API Services, раздел III.E.4); - если у ролика отключены комментарии — пропусти и запиши в лог; - в конце каждого запуска — короткий отчёт: сколько роликов, сколько новых комментариев, сколько единиц квоты, какие ошибки. Сначала покажи план и оценку расхода квоты на мои списки. Потом сделай пробный запуск на 3 роликах и покажи 10 строк из базы. Расписание ставь только после моего «ок».
Разобрать с ИИ
Готовый промпт со ссылкой на материал: пересказ, главные выводы и как применить к вашей задаче.
Посмотреть промпт
Вам может быть интересно
 Claude Code: как пользоваться агентом, который сам работает с вашими файламиУстановка, первая сессия, режимы разрешений, CLAUDE.md и AGENTS.md, навыки, субагенты, хуки и MCP — и честное сравнение с Codex. Всё сверено с документацией на 27 октября 2026
 ИИ-агент простыми словами: обычная модель, которой обустроили рабочее местоПолная версия гайда «ИИ-агенты без магии»: Model, Harness, Loop, Evals и Graph по-человечески, готовые файлы для Codex и Claude Code и план первой недели
 Бэкапы по правилу 3-2-1-1-0: что я понял, когда упал БегетРазбор по горячим следам атаки на Бегет 2 ноября 2026: что такое настоящая резервная копия и что у меня уцелело. Отдельно — путь для тех, у кого сайт делал подрядчик, и для тех, кто работает с агентом
 GitHub с нуля: что это такое и как подключить его к ИИ-агентуДля тех, кто работает с Codex или Claude Code и ни разу не открывал GitHub: восемь понятий, регистрация и один запрос (после него агент сам сделает приватную копию вашей папки). Для тех, у кого есть подрядчик или команда, — правила доступа
 Как найти дело своей жизни: шесть физических шагов вместо поиска предназначенияМоя методика без эзотерики: цепочка из шести действий, воронка из 300 проб, диагностика «пропавшей страсти» и как начать на этом зарабатывать
 Как писать промпты для нейросетей: постановка задачи вместо заклинанийИз чего состоит хороший промпт, какие старые приёмы пора выбросить, примеры «было → стало» и готовые промпты для копирования
 Нейросети для работы: хватит одной-двух, если знать, что им поручатьСемь ассистентов на октябрь 2026 года: что каждый делает лучше, что бесплатно, что работает из России. Карта «задача → инструмент» по профессиям, 152-ФЗ коротко, план первой недели и рабочие промпты
 ТЗ для нейросети: каша в голове даёт кашу на выходеШесть шагов от идеи до описания продукта, по которому нейросеть или разработчик собирают нужное с первого-второго захода: промпты на каждый шаг, сквозной пример и проверка ТЗ
 Как учиться с помощью нейросети: сначала задача, знания — по ходуВайб-лёрнинг на практике: когда спрашивать нейросеть, как сформулировать вопрос, четыре промпта-тренера, учебные режимы ChatGPT, Claude и Gemini и пять ошибок, из-за которых обучение буксует
 Внедрение ИИ в бизнес окупается только в двух случаяхПолная версия гайда об экономике внедрения: два способа выиграть, калькулятор окупаемости с примером, ИИ-агенты и нейросети для бизнеса без иллюзий, точки контроля, 152-ФЗ и типовые ошибки
Источники · 9
- YouTube Data API: начало работы и регистрация приложения
- Калькулятор квот YouTube Data API (снимок 28.10.2026)
- commentThreads.list — параметры и ограничения
- comments.list — ответы на комментарии по parentId
- channels и playlistItems — uploads-плейлист канала
- captions.download — только с правом редактирования ролика
- YouTube API Services Developer Policies, III.E.4 (редакция 15.10.2026)
- Аудит и увеличение квоты
- vidIQ MCP