Одна нейронка не скажет «не знаю» — поэтому Deep Research у меня в четырёх
Где включается глубокое исследование в ChatGPT, Gemini, Claude, Perplexity и Алисе AI, как я распаковываю задачу, пишу один промпт на четыре нейросети и ловлю их на выдумках
Главное за минуту
- Deep Research сам составляет план, делает десятки поисковых запросов и сдаёт отчёт со ссылками. Сейчас он есть в ChatGPT, Gemini, Claude, Perplexity и Алисе AI, бесплатно — везде, кроме Claude, но с жёсткими лимитами.
- Качество решается до запуска: на распаковке задачи и в промпте. Промпт один на все нейросети, с контекстом о вас внутри и с вопросом, который оспаривает саму постановку.
- Одна модель даёт одно мнение уверенным тоном. Ради сведения всё и делается: где модели сошлись, разошлись и где одна нашла то, чего не видят остальные.
- 3–5 ключевых цифр, на которые вы опираетесь в решении, проверяйте по первоисточнику руками. Это двадцать минут, и они отделяют документ от красивого текста.
В статье: Что такое Deep Research и чем он отличается от чата, где он включается в пяти сервисах и сколько дают по тарифам на октябрь 2026 года, мой метод в девять шагов с готовыми промптами, пробный прогон перед полным запуском, очная ставка четырёх отчётов, случаи, когда глубокое исследование подводит, и что делать, если подписка одна. Плюс полтора часа записи живой сессии.
Содержание9 разделов
- Что такое Deep Research и чем он отличается от обычного чата
- Где включить Deep Research: ChatGPT, Gemini, Claude, Perplexity и Алиса
- Мой метод: одно исследование в четырёх нейросетях
- Как написать промпт для Deep Research
- Пробный прогон перед большим исследованием
- Когда глубокое исследование подводит
- Если подписка одна
- Частые вопросы о Deep Research
- Как повторить у себя
Deep Research, или глубокое исследование, — режим нейросети, в котором она сама составляет план, делает десятки поисковых запросов, читает сотни страниц и сдаёт отчёт со ссылками.
Я записал полтора часа того, как реально работаю с глубоким исследованием. Без монтажа, со всеми затупами. Ссылки на видео — в источниках внизу страницы. Здесь тот же метод текстом, с промптами, которые можно копировать, и с тем, где этот режим включается в каждом сервисе на конец октября 2026 года.
Работаете с нейронками, а получаете ответы, будто для всех сразу. Модель не знает, кто спрашивает, и отвечает среднему человеку, которого не существует.
Надо решить в области, где вы не эксперт, а спросить некого. Ниша, локация, поставщик, методика.
Готовите выступление, статью или презентацию, и нужны факты, а не вода. Или проверяете, занята ли ниша и что там на самом деле с конкурентами.
Запускали глубокое исследование, получили красиво упакованную ерунду. Или боитесь, что нейронка соврёт, а вы не заметите.
Что такое Deep Research и чем он отличается от обычного чата
Deep Research отличается от чата тем, что сначала идёт читать, а потом отвечает. Чат на вопрос выдаёт текст из памяти модели и пары найденных страниц — за секунды. Глубокое исследование берёт задачу, раскладывает её на подвопросы, ищет по каждому, сверяет источники между собой и только потом пишет отчёт. Поэтому работает минутами, а иногда часами.
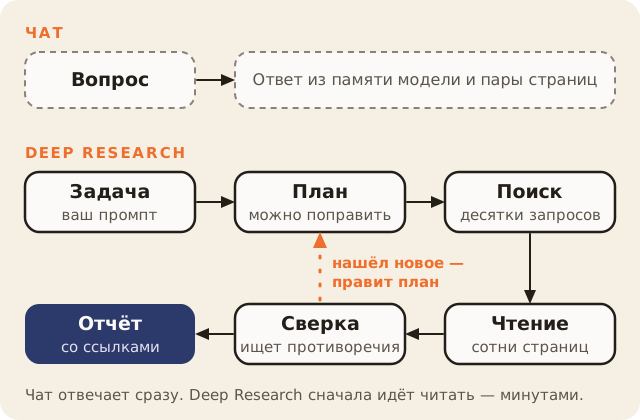
С поисковиком разница та же: часы ручной работы превращаются в задачу, которую вы ставите и уходите.
- Список ссылок
- Открываете, читаете и выписываете сами
- Сравниваете в таблице сами
- Серьёзный вопрос — несколько часов
- План исследования
- Десятки запросов и сотни страниц
- Сравнение и противоречия
- Отчёт со ссылками, пока вы заняты другим
Ловушка в том, что отчёт выглядит одинаково солидно, какими бы ни были источники.
Поисковик — библиотека, где книги ищете вы. Чат — умный собеседник, который делится тем, что помнит. Глубокое исследование — аналитик, который сам идёт в библиотеку, читает, сравнивает и приносит записку. Только записку он пишет одинаково уверенно и когда нашёл, и когда не нашёл.
По устройству это агент: модель с инструментами поиска, которой разрешили делать много шагов подряд и проверять себя. Как такие системы устроены внутри, я разбирал в статье «ИИ-агенты без магии».
Где включить Deep Research: ChatGPT, Gemini, Claude, Perplexity и Алиса
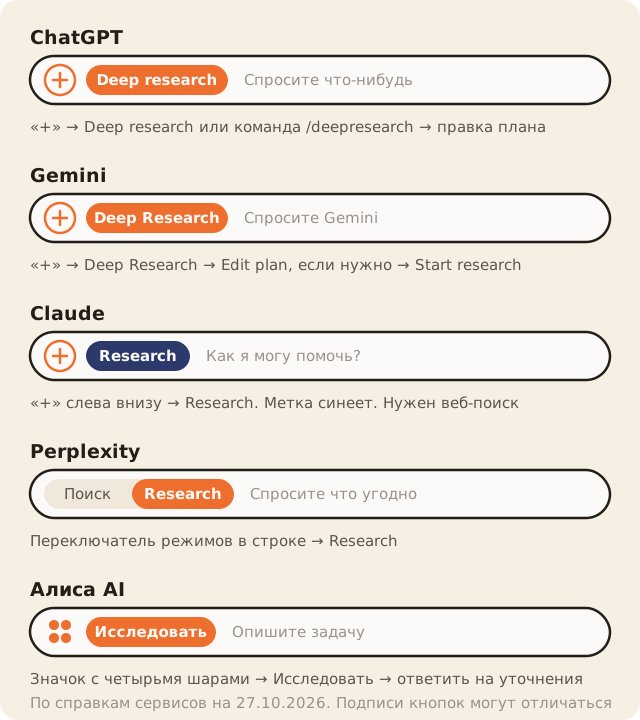
Глубокое исследование на октябрь 2026 года есть в пяти сервисах, которыми пользуются чаще всего: ChatGPT, Gemini, Claude, Perplexity и Алиса AI. Везде оно запускается из строки ввода, но кнопки называются по-разному. Схема собрана по официальным справкам, а не по скриншотам: интерфейсы меняются каждый месяц.
| Без подписки | С подпиской | Сколько идёт | |
|---|---|---|---|
| ChatGPT | Free и Go — ограниченно | Plus — расширенно, Pro — максимум | 5–30 минут |
| Gemini | есть, с дневными лимитами | Plus, Pro, Ultra — лимиты выше | обычно 5–10 минут |
| Claude | нет | Pro, Max, Team, Enterprise | минуты, сложное дольше |
| Perplexity | ограниченно | Pro — больше, Max — ещё больше | самый быстрый, минуты |
| Алиса AI | пробные запросы | Алиса Плюс — до 10 в месяц | от минут до получаса |
Точные числа запусков почти никто больше не публикует. OpenAI пишет на странице тарифов «Limited», «Expanded» и «Maximum», остаток видно в самом интерфейсе. Google считает лимиты общими на все функции и обновляет их каждые 5 часов до недельного потолка. Проверено 27 октября 2026 года, ссылки на справки — в источниках.
ChatGPT
Deep research включается через «+» в строке ввода или командой /deepresearch. Перед стартом ChatGPT показывает план, его можно поправить, а по ходу — прервать и уточнить направление. В «Sites → Manage sites» исследование ограничивают нужными сайтами или просят их приоритет. Подключённые приложения работают только на чтение. Готовый отчёт открывается на весь экран с оглавлением, списком источников и историей действий, скачивается в Markdown, Word или PDF.
Gemini
В Gemini глубокое исследование теперь есть и без подписки, это главное изменение с прошлого года. Дальше «+», Deep Research, при желании «Edit plan» — и «Start research». Источники: Google Поиск, загруженные файлы, блокноты NotebookLM, а при подключённом Google Workspace — Gmail и Диск. Отчёт открывается в Canvas: оттуда его выгружают в Google Документы, делают аудиопересказ и визуализации. В Pro и Ultra отчёт можно строить на более сильной модели, в Ultra в нём бывают графики, диаграммы и интерактивные симуляции. Режим доступен с 18 лет.
Claude
Research в Claude — только на платных тарифах, бесплатно его нет. Включается через «+» слева внизу, метка становится синей. Нужен включённый веб-поиск. Кроме интернета Claude ищет в подключённых Gmail, Календаре, Google Документах и других коннекторах — но только если исследование запущено с сайта или из приложения на компьютере, с телефона он ходит только в веб. Лимит общий с обычными чатами и расходуется быстрее. Сам режим, по справке Anthropic, работает на Claude Opus 5.5 (при нагрузке может переключиться на Opus 4.8), какую бы модель вы ни выбрали в чате.
Perplexity
В Perplexity режим выбирается переключателем в строке поиска — «Research». Бесплатно доступ ограничен, на Pro лимит больше, на Max ещё выше, сбрасывается он скользящим окном, а не по дате оплаты. С конца октября 2026 года Deep Research начинает переезжать в Perplexity Computer как встроенный навык — первыми в веб-версии его получают Pro и Max: сначала тратится бесплатный объём, потом кредиты.
Алиса AI
Агент «Исследовать» открыт для всех с апреля 2026 года, работает на alice.yandex.ru, в приложениях Алиса AI и Яндекс с Алисой AI и в Яндекс Браузере, только в России. Включается значком с четырьмя шарами в строке ввода. Перед стартом Алиса задаёт уточняющие вопросы, а для проверки расчётов пишет и запускает код. Отчёт скачивается в PDF или DOCX.
Без подписки — пробные запросы. Алиса Плюс за 199 ₽ в месяц даёт приоритетную очередь и до 10 исследований в месяц. Буст за 100 ₽ — ещё 10 запросов на месяц.
К одному исследованию — не больше одного файла. Всё, что вы напишете после запуска, в исследование уже не попадёт.
Что я вижу на практике
Справки описывают кнопки. Как модели ведут себя на одном и том же промпте, видно только руками. Вот что у меня повторяется из раза в раз:
Сильнее всех по источникам и глубине. Долго. Может пересоздавать файл по нескольку раз — это нормально.
Быстрее всех, текста меньше, качество часто выше. Проверьте, что включён именно Research: обычный режим выдаст разведку за минуту, а вы примете её за исследование.
Много источников быстро. Пишет коротко — объём надо требовать. Склонен выдумывать кейсы, которые выглядят как настоящие.
Хорош, когда в форме. Классическая ловушка: получает промпт и начинает исследовать сам промпт. Пишите «проведи глубокое исследование ПО прикреплённому промпту».
Для чувствительных тем, где остальные упираются в ограничения, я дополнительно беру Grok.
Мой метод: одно исследование в четырёх нейросетях
Метод нужен, потому что одна нейронка даёт не ответ, а одно мнение — уверенным тоном. Она не скажет «я не знаю», а сгенерирует правдоподобное. Проверить вы не можете: ровно за этим к ней и пришли. Отсюда вся конструкция — одна задача, четыре независимых исследования и очная ставка между ними.
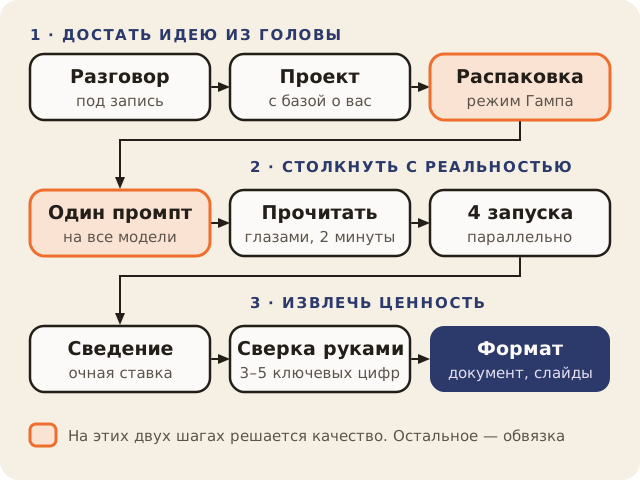
Сколько это стоит по времени, деньгам и навыкам:
Около двух часов на средний цикл. Вашего активного участия — минут двадцать, остальное модели работают сами.
Платные подписки хотя бы на две модели. На бесплатных тоже работает, но лимиты там короткие.
Никаких. Всё делается текстом в чате. Первый раз берите две модели вместо четырёх — эффект уже будет виден.
С какой задачи началось
Метод отработан на живом случае. Встретились со знакомым предпринимателем. Через две недели у него выступление в бизнес-клубе, тема — выбор маржинальной ниши. Свой опыт есть, но непонятно, с чего заходить и что вообще сейчас есть в поле. Сели распаковывать, и через четыре минуты выяснилось, что задачи две, а вторая интереснее первой.
Началось с бытового. Выбираешь направление, упираешься в расчёт, а как считать — непонятно: в каждой нише модель своя. Хорошо бы сервис, который посчитает и честно скажет: хочешь миллион с этой точки — нужна тысяча чеков в день, сходи на локацию и померь трафик, там таких людей нет. К концу разговора это выросло в ленту идей, уже выстреливших на Западе, финмодель под идею и локацию, персонализацию под профиль человека и медийный слой с партнёркой вместо подписки.
Дальше — тот путь, который прошли мы.
Часть 1 · Достать идею из головы
Проговорить вслух под запись
Не садиться писать ТЗ, а проговорить — себе, партнёру, кому угодно, хоть в машине. Письменно вы формулируете то, что уже осознали. Вслух вытаскиваете то, что ещё нет: речь опережает самоцензуру, рука успевает выкинуть «глупое», язык — нет. В нашем разговоре из болтовни про китайца, который делает окна-имитацию солнца, за сорок минут вырос целый слой продукта. Никто его не придумывал, он выпал из разговора.
Запись — на диктофон, расшифровка — с делением на спикеров, например в MyMeet. Деление критично: без него модель слепит ваши сомнения с чужими утверждениями в одну кашу. Промпты дальше удобно надиктовывать — какие говорилки для этого я гонял, разбирал отдельно.
Поставить постоянный контекст
Этот шаг пропускают все, а потом жалуются на общие ответы. Один раз соберите проект с базой о себе: в Claude и ChatGPT это Projects, в Gemini — Gems. Туда — честная биография (что умеете, чего нет, где обжигались), действующие проекты с реальными цифрами и проблемами, тон голоса, если будете просить тексты, профили партнёров. Что нейросеть уже помнит о вас сама, тоже полезно выгрузить и проверить.
Собирая базу о себе, многие впервые пишут свою распаковку — и обнаруживают, что не могут внятно ответить, в чём они сильнее большинства. Это открытие полезнее половины исследований.
Режим Форреста Гампа
Не просите сразу промпт. Попросите объяснить вам вашу же задачу. Обычно вы формулируете процентов тридцать, остальное сидит в голове как «очевидное».
Вот расшифровка разговора о задаче. Посмотри, что здесь вообще есть, и декомпозируй. Дай подробный разбор: что ты понял, какие задачи видишь, что тут главное, а что второстепенное.

Если чего-то не хватает для понимания — задай мне вопросы, а не додумывай.
У нас модель разложила вторую задачу на две: «инструмент под себя» и «продукт для рынка». Человек посмотрел и сказал: акцент на продукт. Одна фраза, пятнадцать секунд — без неё промпт ушёл бы не туда, и на выходе было бы 50 страниц исследования не о том.
Кривая формулировка на этом шаге не всплывёт до самого конца. А потом испортит всё разом.
Часть 2 · Столкнуть идею с реальностью
Один промпт на все нейросети
Теперь просите промпт для глубокого исследования — в том же проекте. Модель по умолчанию предложит четыре «адаптированных» версии под каждый сервис. Не соглашайтесь: результаты станут несравнимыми, и вы не поймёте, где модели разошлись во мнениях, а где им задали разные вопросы. Требования к промпту проговорите явно, сама модель их не подставит.
Контекст о вас — в проекте→Блок о вас зашит прямо в текст промпта: три другие модели вашего проекта не видят«Изучи эти подходы: …»→«…и не ограничивайся этим списком, ищи то, чего я не назвал»«Какие есть подходы»→«Как конкретные люди это делали и что вышло» — и отдельно провалыБез дат→Было → что сломалось → как сейчас → прогнозЦифры как есть→Год и первоисточник у каждой цифрыОбъём на усмотрение модели→«Не сокращай, минимум 30 страниц, с кейсами и примерами» — модели экономят токены
И главное — провокация: вопрос, который ставит под сомнение саму постановку задачи. Мы добавили один пункт: «формулировка “маржинальная ниша” может быть некорректной — поищите, кто из авторов это проговаривает». Этот пункт дал главный тезис всего выступления. Без него на выходе был бы список ниш — ровно то, что зал слышал сто раз.
Отдельным блоком: проверь саму постановку вопроса. Возможно, «[ваша формулировка]» — некорректная рамка. Найди авторов и данные, которые оспаривают саму эту постановку, а не отвечают на неё.Промпт просите выгрузить Markdown-файлом: он поедет во все нейросети одинаковым, без потери форматирования. Сложная задача — длинный промпт. Мой рекорд — 24 страницы под запуск танцевальной студии. Исследование по нему шло два часа и прошло тысячу сайтов, и это нормально.
Прочитать промпт глазами
Две минуты, которые экономят два часа исследования не в ту сторону. Обычные правки: снять лишнее ограничение, добавить требование реальных кейсов, добавить срез по времени, сместить приоритет со второстепенной задачи на главную. Это последнее место, где процесс ещё можно дёшево развернуть.
Запустить параллельно
Четыре вкладки, один и тот же файл, и в каждой включён именно режим глубокого исследования. Дальше можно уходить заниматься другим: в зависимости от промпта это от 5 минут до двух с половиной часов. Каждый результат сразу скачивайте как .md с понятным именем — «Исследование_Gemini.md», «Исследование_Perplexity.md» — в одну папку. Через час вы не вспомните, что откуда.
Часть 3 · Извлечь ценность
Сведение и очная ставка
Четыре исследования — ещё не результат. Результат появляется, когда вы сталкиваете их лбами. Все файлы — обратно в основную модель, ту, где лежит проект с базой о вас.
Прикрепляю результаты исследований из разных нейросетей по одному и тому же промпту.

1. Сначала кратко: кто справился лучше, где модели разошлись, что одна нашла, а другие пропустили, где есть подозрение на выдумку.
2. Отдельным списком выпиши все цифры и кейсы: у какой модели встречаются и есть ли ссылка на первоисточник.
3. Пометь «проверить руками» всё, что есть только у одной модели, и всё, что у всех одинаково, но без ссылки.
4. Потом — объединённый документ со всеми ссылками, примерами и рекомендациями в конце. Не сокращай.

Ничего не добавляй от себя. Если данных нет, так и пиши.
Сведение я читаю по трём корзинам. Первая обманчивее, чем кажется: на нашем случае три модели сошлись — и ошиблись вместе.
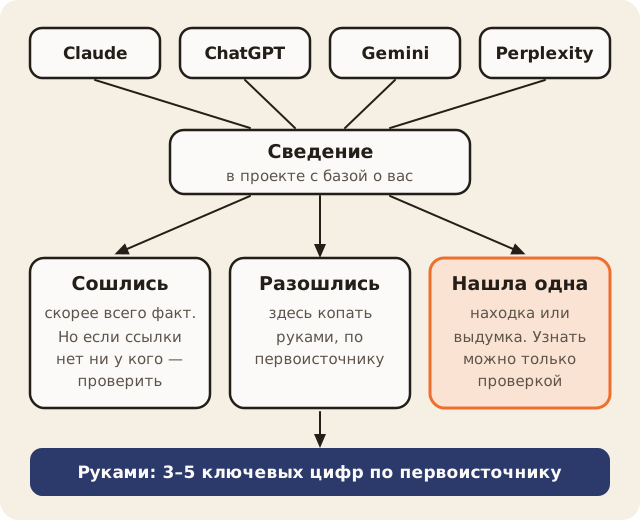
На нашем случае один проход сведения поймал три вещи:
Три нейронки уверенно назвали одну и ту же ключевую ставку ЦБ — и все три неверно. Проверка по сайту регулятора показала другую цифру.
У Gemini часть российских кейсов оказалась синтетической: красивые истории с именами, цифрами и деталями, которых не было.
Работающий западный аналог продукта за 500 долларов в год сама не нашла ни одна модель. Бесплатный государственный сервис-конкурент пропустили две из трёх. Всплыли на сверке.
Выйди человек с той ставкой на сцену перед предпринимателями — поправили бы из зала, и весь остальной доклад слушали бы уже по-другому. Одна модель не скажет «я не знаю» — она сгенерирует правдоподобное. А вы потом повторите это с трибуны или инвестору.
Цифры, на которые вы реально опираетесь в решении, проверьте по первоисточнику сами. Их обычно три-пять на всё исследование. Это двадцать минут, и они отделяют документ от красивого текста.
Превратить в то, чем можно пользоваться
Сто страниц исследования — сырьё. Из него делается то, что нужно именно вам.
«Дай документ, который полезно и интересно читать, с примерами и ссылками». Хорошо работают пометки: что говорить со сцены, где осторожно с цифрой, что лично для меня.
Сначала просите HTML, горизонтальный, 16:9, потом переводите в PPTX. Сразу .pptx нейросеть нарисует, но плохо. Проверьте контраст: тёмный фон с проектора не читается.
Если выросла идея продукта: «как это выглядит в MVP, буду собирать на Lovable, дай промпт». Конкуренты, аудитория и экономика уже в исследовании — промпт выходит предметным.
Если исследование нужно под презентацию или КП, дальше оно становится первым из трёх шагов метода тройного исследования: внешняя разведка, ваши собственные данные и их пересечение.
Как написать промпт для Deep Research
Промпт для глубокого исследования — это тот же разговор с подрядчиком, только подрядчик не переспросит. Всё, что вы не написали, он додумает сам, и додумает под среднего человека. Поэтому промпт у меня собирается не по шаблону «роль — задача — формат», а из тех вопросов, на которых модели чаще всего меня подводили.
Кто спрашивает. Без этого блока вы получите отчёт «для всех» — то есть ни для кого. Что решаю: не тема, а решение, которое я приму по итогам. Что уже знаю — и требование не останавливаться на моём списке. Чьи реальные истории нужны, включая провалы. За какой период и как всё менялось. Откуда брать цифры. И вопрос, который бьёт по самой постановке.
Мой рабочий каркас. Квадратные скобки — под себя, лишнее выкидывайте без жалости:
# Кто спрашивает
Я [кто вы, чем занимаетесь, где]. Ресурсы: [деньги, люди, время]. Ограничения: [чего точно не могу или не хочу].
Пиши рекомендации под меня, а не под абстрактного предпринимателя.

# Что решаю
По итогам я [выступлю / вложусь / откажусь / выберу]. Мне нужно понять: [один вопрос].
Сейчас я склоняюсь к [гипотеза]. Ищи в первую очередь то, что её ломает.

# Что я уже знаю
[Что видел, читал, пробовал.] Это стартовая точка, а не рамка: ищи то, чего я не назвал.

# Чьи истории
Конкретные люди и компании: что делали, сколько вложили, что вышло. Провалы — отдельным разделом, они важнее успехов.

# Время
Было → что сломалось → как сейчас → куда идёт. Данные старше [год] помечай как устаревшие.

# Цифры
У каждой — год и ссылка на первоисточник, не на пересказ. Нет данных — так и пиши. Источники спорят — дай обе версии.

# Проверка постановки
Возможно, «[моя формулировка]» — кривая рамка. Найди тех, кто её оспаривает, и объясни почему.

# Что на выходе
Резюме на страницу, потом разбор по разделам, таблица сравнения, в конце — выводы, риски и что проверить руками.
Не сокращай: минимум [число] страниц, с кейсами и примерами.
Писать такое с чистого листа не нужно. Пусть промпт соберёт та модель, где лежит проект с базой о вас, — из расшифровки разговора, а не из головы:
Собери из нашего разговора промпт для глубокого исследования. Один на все нейросети, без адаптаций под каждую.
Блоки: кто спрашивает (перенеси сюда всё важное обо мне из проекта — другие модели его не видят), что решаю и моя гипотеза, что я уже знаю, чьи истории нужны, период, требования к цифрам, проверка постановки, формат.
Не ограничивай поиск моим списком. Требуй провалы, год и первоисточник у каждой цифры. Если чего-то не хватает — сначала спроси меня.
Как меняется запрос, видно на той же задаче из бизнес-клуба:
«Какие ниши сейчас самые маржинальные?»→«Я готовлю выступление для предпринимателей бизнес-клуба. Нужны ниши, где малый бизнес в России держит высокую маржу последние два-три года: реальные примеры с цифрами, провалы и почему. Отдельно — кто считает саму идею „маржинальной ниши“ ложной и почему»
Пробный прогон перед большим исследованием
Большое исследование — это час-два ожидания и сотня страниц. Если модель поняла задачу криво, вы узнаете об этом только в конце. Поэтому, когда на кону деньги или тема для меня совсем новая, я сначала гоняю тот же промпт в урезанном виде: пусть покажет, куда собирается копать.
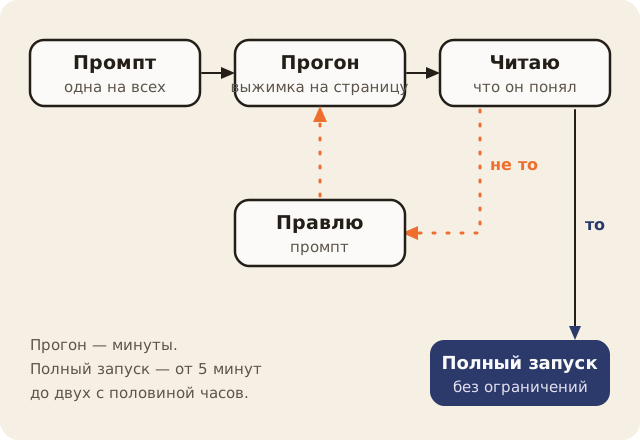
В конец промпта дописываю:
Пока не делай полное исследование. Сначала короткий прогон: выжимка на страницу.
Покажи, как ты понял задачу, какие источники собираешься брать и в какую сторону пойдёшь дальше.
Я посмотрю и скажу, запускать ли полностью.
Смотрю на три вещи. Понял ли он, о чём речь, — или уехал в соседнюю тему, потому что термин многозначный. Где ищет: в источниках нужной страны и нужных лет — или в агрегаторах, пересказывающих друг друга. И есть ли в выжимке хоть одна цифра с фамилией и датой — или три абзаца общих слов. Если не то, правлю промпт и гоняю ещё раз. Если то — убираю абзац про прогон и запускаю на полную.
Когда глубокое исследование подводит
Глубокое исследование подводит там, где ответа нет в открытом интернете. Модель в таких местах не останавливается и не говорит «не нашёл» — она дописывает недостающее так же гладко, как всё остальное. Поэтому полезно заранее знать, где тонко.
Свежие новости и выступления ещё не разошлись по сайтам. Модель соберёт картину из старого и подаст как новое. Для свежака — обычный поиск и первоисточник.
Ключевая ставка, которую три модели у меня назвали одинаково и неверно, — отсюда. Всё, что меняется чаще раза в квартал, сверяйте на сайте того, кто это число устанавливает.
Платное исследование модель видит по анонсу. Остальное она реконструирует. Нужный отчёт загружайте файлом сами.
Сколько людей проходит мимо точки, что говорят клиенты конкурента, как пахнет в помещении. Этого нет ни в одном источнике. Исследование подскажет, что мерить, но мерить придётся ногами.
Отчёт поможет прийти к врачу или юристу с правильными вопросами. Диагноза и решения по договору в нём быть не может.
«Почему конкурент на самом деле закрылся» — это догадки. Просите факты и версии, которые кто-то озвучил под своим именем.
Признаки выдумки
Вот на чём я ловил модели сам:
Кейс с именем, городом и выручкой→Вбейте имя в поиск. Синтетические российские кейсы Gemini выглядели именно так — убедительно и подробноЦифра без года→Скорее всего, пересказ пересказа. Без первоисточника в решение не беритеВсе модели сошлись, ссылки нет→Они могли ошибиться вместе — как с той ставкой. Согласие без ссылки ещё не фактСсылка есть, но ведёт на главную→Откройте и найдите цифру на странице. Не нашли — её там нетОтчёт подтверждает всё, что вы думали→Проверьте вдвойне, особенно если гипотезу вы сами вписали в промпт
Если подписка одна
Метод с одной нейросетью деградирует, но не ломается. Основной эффект — перекрёстная проверка — появляется уже на двух моделях, лучше максимально разных по устройству. Глубокое исследование бесплатно есть в Gemini, ChatGPT, Perplexity и Алисе — с короткими лимитами, но на вторую модель для сверки их хватит.
- Один промпт дважды в одну модель, в разных чатах. Слабее, чем разные модели, но расхождения всё равно вылезут — и это уже сигнал.
- Самопроверка. «Пройдись по своему ответу и отметь, где ты не уверен, где цифра может быть устаревшей, а где ты её реконструировал». Модели на удивление честно это отрабатывают, когда спросить прямо.
- Цифры руками. Три-пять ключевых, двадцать минут. Работает всегда и не требует подписок вообще.
Даже четыре модели и идеальный промпт не закрывают всего.
Разговор с человеком, который в теме давно, и ваша полевая проверка: сходить на локацию, померить трафик, поговорить с клиентом. Исследование готовит вас к этим действиям, но не отменяет их.
Метод работает не только на бизнес. Тем же способом я гонял исследование по методикам развития голоса — от советских наработок до современных. И не останавливайтесь, если нашёлся конкурент: люди часто добиваются успеха как раз потому, что не знали про аналог, а вам не нужно 100% рынка. Проверить, нужен ли продукт людям, можно и без опросов, на синтетических покупателях.
Метод не превращает вас в эксперта. Он даёт другое: за два часа вы приходите к эксперту не с пустой головой, а с картой, вопросами и понятными пробелами.
Частые вопросы о Deep Research
Что такое Deep Research простыми словами?
Deep Research — режим нейросети, в котором она не отвечает сразу, а проводит небольшое исследование. Составляет план, делает десятки поисковых запросов, читает сотни страниц, сверяет их между собой и сдаёт структурированный отчёт со ссылками на источники. Обычный чат отвечает за секунды, глубокое исследование работает от нескольких минут до пары часов.
Где можно сделать Deep Research бесплатно?
Бесплатно глубокое исследование на октябрь 2026 года есть в Gemini, ChatGPT (тарифы Free и Go), Perplexity и Алисе AI — везде с жёсткими лимитами. В Gemini действуют дневные лимиты, в Алисе даются пробные запросы. В Claude режим Research только на платных тарифах, начиная с Pro.
Сколько длится глубокое исследование?
Глубокое исследование длится от пары минут до нескольких часов — зависит от сервиса и промпта. По справкам: ChatGPT — 5–30 минут, Gemini — обычно 5–10, Алиса AI — от нескольких минут до получаса, Perplexity — быстрее всех. В моей практике сложный промпт на 24 страницы шёл два часа и прошёл тысячу сайтов. Ждать у экрана не нужно: сервисы присылают уведомление.
Какой Deep Research лучше: ChatGPT, Gemini, Claude или Perplexity?
Лучшего Deep Research нет: у каждого свои ошибки, и поэтому я запускаю один промпт в четырёх. По моему опыту Claude сильнее по источникам и глубине, Perplexity быстрее всех, Gemini берёт много источников, но выдумывает кейсы, ChatGPT иногда исследует сам промпт вместо задачи. Если подписка одна, берите ту, где у вас проект с базой о себе.
Как включить Deep Research в ChatGPT?
Deep Research в ChatGPT включается через «+» в строке ввода — пункт Deep research — или командой /deepresearch. ChatGPT покажет план, его можно поправить до старта. Через «Sites → Manage sites» поиск ограничивают нужными сайтами. Готовый отчёт скачивается в Markdown, Word или PDF.
Можно ли доверять отчёту Deep Research?
Доверять отчёту Deep Research целиком нельзя: модель уверенно пишет и найденное, и додуманное. Ссылки помогают проследить источник, но открывать их всё равно нужно. Сверяйте отчёты нескольких моделей, требуйте год и первоисточник у каждой цифры и проверяйте руками три-пять цифр, на которых стоит ваше решение.
Как повторить у себя
- Соберите в одной нейросети проект с базой о себе и запускайте исследования оттуда, а не из пустого чата.
- Проговорите следующую задачу под запись и попросите модель разобрать её, прежде чем писать промпт.
- Отправьте один промпт минимум в две модели параллельно, а дорогую задачу начните с пробного прогона.
- Сведите отчёты и выпишите цифры, которые есть только у одной модели или у всех без ссылки, — их проверяйте руками, прежде чем нести на сцену.
Если хочется разобраться с нейросетями не в одиночку, а на своих задачах, — у меня есть курс работы с ИИ-агентами «Нейрологика».
Чек-лист глубокого исследования
Когда пользоваться: Держать открытым во время исследования, которое пойдёт в решение по деньгам, выступление или презентацию, и идти по пунктам
Достать идею
[ ] Задача проговорена под запись — себе или партнёру
[ ] Расшифровка с делением на спикеров
[ ] Открыт проект с базой о себе (собрать один раз)
[ ] Расшифровка разобрана: «декомпозируй, задай вопросы, не додумывай»
[ ] Разбор прочитан, приоритеты поправлены

Столкнуть с реальностью
[ ] Один промпт на все модели, в .md, контекст о себе внутри текста
[ ] Нет ограничения «ищи только из этого списка»
[ ] Требуются реальные кейсы и провалы
[ ] Задан охват по времени: было → сломалось → сейчас → прогноз
[ ] Требуются первоисточники и год у каждой цифры
[ ] Задан объём
[ ] Заложена провокация — вопрос, оспаривающий саму постановку
[ ] Для дорогой задачи сначала пробный прогон с выжимкой на страницу
[ ] Везде включён именно режим глубокого исследования
[ ] Все отчёты скачаны как .md с понятными именами в одну папку

Извлечь ценность
[ ] Сведение в одной модели: где сошлись, где разошлись, кто что пропустил
[ ] 3–5 ключевых цифр проверены руками по первоисточникам
[ ] Сырьё превращено в формат: методичка, слайды через HTML, промпт для MVP
[ ] Записано, что осталось проверить в поле
Достать идею [ ] Задача проговорена под запись — себе или партнёру [ ] Расшифровка с делением на спикеров [ ] Открыт проект с базой о себе (собрать один раз) [ ] Расшифровка разобрана: «декомпозируй, задай вопросы, не додумывай» [ ] Разбор прочитан, приоритеты поправлены Столкнуть с реальностью [ ] Один промпт на все модели, в .md, контекст о себе внутри текста [ ] Нет ограничения «ищи только из этого списка» [ ] Требуются реальные кейсы и провалы [ ] Задан охват по времени: было → сломалось → сейчас → прогноз [ ] Требуются первоисточники и год у каждой цифры [ ] Задан объём [ ] Заложена провокация — вопрос, оспаривающий саму постановку [ ] Для дорогой задачи сначала пробный прогон с выжимкой на страницу [ ] Везде включён именно режим глубокого исследования [ ] Все отчёты скачаны как .md с понятными именами в одну папку Извлечь ценность [ ] Сведение в одной модели: где сошлись, где разошлись, кто что пропустил [ ] 3–5 ключевых цифр проверены руками по первоисточникам [ ] Сырьё превращено в формат: методичка, слайды через HTML, промпт для MVP [ ] Записано, что осталось проверить в поле
Разобрать с ИИ
Готовый промпт со ссылкой на материал: пересказ, главные выводы и как применить к вашей задаче.
Посмотреть промпт
Вам может быть интересно
 ИИ-агент простыми словами: обычная модель, которой обустроили рабочее местоПолная версия гайда «ИИ-агенты без магии»: Model, Harness, Loop, Evals и Graph по-человечески, готовые файлы для Codex и Claude Code и план первой недели
 Купят ли ваш продукт, можно узнать за вечер — без опросовКак синтетические покупатели помогают отсеять слабые идеи до дорогого исследования
 Бэкапы по правилу 3-2-1-1-0: что я понял, когда упал БегетРазбор по горячим следам атаки на Бегет 2 ноября 2026: что такое настоящая резервная копия и что у меня уцелело. Отдельно — путь для тех, у кого сайт делал подрядчик, и для тех, кто работает с агентом
 GitHub с нуля: что это такое и как подключить его к ИИ-агентуДля тех, кто работает с Codex или Claude Code и ни разу не открывал GitHub: восемь понятий, регистрация и один запрос (после него агент сам сделает приватную копию вашей папки). Для тех, у кого есть подрядчик или команда, — правила доступа
 Как найти дело своей жизни: шесть физических шагов вместо поиска предназначенияМоя методика без эзотерики: цепочка из шести действий, воронка из 300 проб, диагностика «пропавшей страсти» и как начать на этом зарабатывать
 Как научить агента собирать комментарии с YouTube каждый деньПошагово: ключ YouTube Data API за 15 минут, промпт для Claude Code или Codex, расчёт квоты и правила, о которых агент обычно не предупреждает
 Claude Code: как пользоваться агентом, который сам работает с вашими файламиУстановка, первая сессия, режимы разрешений, CLAUDE.md и AGENTS.md, навыки, субагенты, хуки и MCP — и честное сравнение с Codex. Всё сверено с документацией на 27 октября 2026
 Как писать промпты для нейросетей: постановка задачи вместо заклинанийИз чего состоит хороший промпт, какие старые приёмы пора выбросить, примеры «было → стало» и готовые промпты для копирования
 Нейросети для работы: хватит одной-двух, если знать, что им поручатьСемь ассистентов на октябрь 2026 года: что каждый делает лучше, что бесплатно, что работает из России. Карта «задача → инструмент» по профессиям, 152-ФЗ коротко, план первой недели и рабочие промпты
 ТЗ для нейросети: каша в голове даёт кашу на выходеШесть шагов от идеи до описания продукта, по которому нейросеть или разработчик собирают нужное с первого-второго захода: промпты на каждый шаг, сквозной пример и проверка ТЗ
Источники · 20
- Мой опыт: запись реальной рабочей сессии, участник обезличен
- Мой гайд «Метод глубокого исследования» — эта страница его веб-версия, данные о сервисах обновлены
- Видео на YouTube
- Видео на Rutube
- Видео в Дзене
- Видео во ВКонтакте
- Оригинал — пост в Telegram
- OpenAI — Deep research in ChatGPT (справка: запуск, сайты, план, экспорт; проверено 27.10.2026)
- OpenAI Academy — Deep research (обновлено 02.09.2026)
- ChatGPT — тарифы: Free и Go «Limited», Plus «Expanded», Pro «Maximum» (проверено 27.10.2026)
- OpenAI — Introducing deep research: от 5 до 30 минут на задачу (запуск, февраль 2025)
- Google — Use Deep Research in Gemini Apps (справка, проверено 27.10.2026)
- Google — Gemini Apps limits & feature availability (лимиты по тарифам, проверено 27.10.2026)
- Anthropic — Use research on Claude (справка, проверено 27.10.2026)
- Claude — тарифы: Research с Pro и выше (проверено 27.10.2026)
- Perplexity — What is Research mode? (справка)
- Perplexity — Deep Research and Model Council in Computer (справка, 26.10.2026)
- Яндекс — агент «Исследовать» в чате с Алисой AI (справка, проверено 27.10.2026)
- Яндекс — всем пользователям Алисы AI стал доступен агент «Исследовать» (02.04.2026)
- Яндекс — опция Алиса Плюс, 199 ₽ в месяц (справка, проверено 27.10.2026)