Презентация начинается за три шага до слайдов
Метод тройного исследования: как собрать смыслы для продающего материала за день, а не за месяц
Главное за минуту
- Когда презентация выходит «на троечку», почти всегда дело в пропущенной подготовке, а инструмент тут ни при чём.
- Смыслы собираются из трёх источников: рынок снаружи, ваши собственные данные внутри и их пересечение.
- Нейросеть хорошо исполняет детальное ТЗ. Стратегию за вас она не придумает.
В статье: Три шага, которые я прохожу до любой презентации, лендинга или КП: внешняя разведка, внутренний аудит, синтез в «книгу продаж». Плюс проверка черновика виртуальной фокус-группой.
Содержание6 разделов
Недавно на созвоне с одним из проектов случилась типичная история. Запрос звучал так: «Нужна презентация для продажи дорогого продукта. Менеджеры не могут нормально объяснить клиентам, что они получат. Хотим красивые слайды».
Человек уже даже начал. Залез в Genspark, накидал вводных, получил что-то на троечку — и пришёл ко мне с вопросом: «Где лучше делать презентации? Может, есть инструмент покруче?»
А вопрос вообще не в инструменте.
Я честно говорю: «ГДЕ делать — это последний шаг. Давай сначала разберёмся, ЧТО ты хочешь донести и КОМУ».
Дальше рассказываю подход, который у меня сложился за десятки таких проектов. Называю его методом тройного исследования. Звучит умно, но по сути это то, что любой нормальный маркетолог делал и до нейросетей. Просто раньше на это уходил месяц, а сейчас — день.
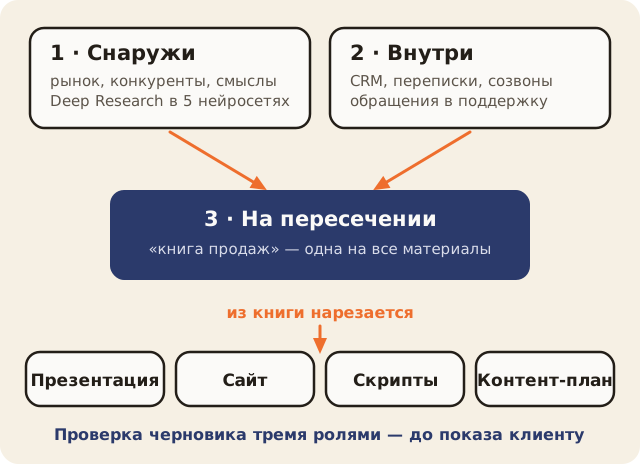
Шаг 1. Что происходит снаружи?
Прежде чем открывать любой конструктор презентаций, нужно понять контекст. Кто конкуренты? Как они продают похожий продукт? Какие смыслы используют? На что реагирует аудитория?
Я запускаю глубокое исследование (Deep Research) параллельно в пяти нейросетях: Perplexity, Claude, ChatGPT, Genspark, Gemini. Один и тот же запрос, чуть подогнанный под каждую, — в пять разных мозгов. Каждая думает по-своему, ходит по своим источникам и замечает своё.
В среднем каждая проходит по сотням сайтов и думает от 20 минут до двух часов.
Потом сливаю все пять исследований в Claude и прошу: соедини, покажи, что совпало, что противоречит, какие выводы главные.
На выходе — документ, собранный из 1500+ источников. Руками такое собирают месяц. Здесь — несколько часов, из которых ваших активных действий минут на тридцать.
Режим нейросети, в котором она сама составляет план поиска, обходит десятки и сотни страниц и отдаёт сводный отчёт со ссылками. Обычный чат отвечает из головы, Deep Research сначала идёт читать.
Шаг 2. Что лежит у вас внутри?
Внешнюю картину рынка знают все. А свои собственные данные толком не анализирует почти никто.
В CRM лежат продажи, есть переписки с клиентами, записи созвонов, обращения в поддержку. И большая часть этого просто пылится.
Я говорю: загрузи всё это в Claude или ChatGPT через Deep Research. Пусть нейросеть найдёт то, чего ты сам не видишь.
На одном проекте (строительная ниша) так обнаружилось, что 70% сделок закрывались в январе–феврале: клиенты планируют бюджет на год. А компания не усиливала маркетинг в декабре. Просто не замечали закономерность.
На другом выяснили, что 80% клиентов спрашивали в переписках одно и то же, но ответа на этот вопрос в коммерческом предложении не было. Добавили — конверсия выросла.
Такие вещи нейросеть вытаскивает за час из данных, которые у вас уже есть.
Шаг 3. Что получается на пересечении?
Теперь самое интересное. Берём внешнюю разведку, кладём рядом внутренний аудит и соединяем.
На пересечении появляются настоящие решения. Вместо «мне кажется, наша аудитория хочет вот это» — что-то вроде «данные показывают, что заметная доля наших клиентов — сегмент, которому мы вообще не продаём, потому что у нас нет для них подходящего формата».
На этом этапе я прошу Claude собрать «большую книгу продаж» — документ, из которого потом нарезается всё остальное: презентация, тексты для сайта, скрипты для менеджеров, контент-план, лид-магниты.
Одна книга продаж — десятки единиц контента.
Как проверить черновик до живых людей?
Черновик проверяют в нейросети на виртуальных копиях людей: я прогоняю его через три фильтра — клиент, профессионал в нише и дизайнер.
Есть исследование Стэнфорда: 1052 человека, с каждым двухчасовое глубинное интервью, всё загрузили в нейросеть. Потом виртуальным копиям задавали вопросы — в том числе «купишь этот продукт или нет? почему?». Копии воспроизводили ответы человека с точностью 85% от того, насколько точно сам человек повторяет свои ответы через две недели.
Я этим пользуюсь постоянно. Когда черновик готов, прогоняю его через три фильтра:
Который ничего о нас не знает: что непонятно, где бы ты закрыл файл
Где слабо, что не выдерживает проверки
Где визуально проседает, что поменять
Три прохода — и материал проверен до того, как его увидел хоть один живой клиент.
И только теперь — презентация
Вот на этом этапе вы открываете Genspark (или что вам больше нравится). На руках полная картина: кто аудитория, какие смыслы работают, что на каком слайде, какой визуал.
Нейросеть здесь работает исполнителем. Вы приходите к ней с детальным ТЗ вместо «ну сделай мне красиво». Разница колоссальная.
Когда я всё это объяснил на созвоне, человек сказал: «Блин, я-то думал, у меня проблема с инструментом. А я просто пропустил всю подготовку и сразу полез рисовать слайды».
Вот именно. Большинство так и делает. Потом три часа воюют с вёрсткой, получают «что-то на троечку» и решают, что нейросети пока не умеют делать презентации.
Умеют. Но им нужно дать правильный материал.
Дело не в ИИнструменте. Genspark, Gamma, Gemini Notebook (бывший NotebookLM) делают ровно то, что вы просите. Когда смыслы на месте, презентация собирается за полчаса. Когда их нет, не спасёт ни один сервис.
Как применить к своей презентации
- Перед следующей презентацией или КП запустите одно и то же исследование рынка хотя бы в двух-трёх нейросетях и попросите третью свести результаты.
- Выгрузите переписки, записи созвонов и обращения в поддержку за последние месяцы и спросите у нейросети, какие вопросы клиенты задают чаще всего — и есть ли на них ответ в ваших материалах.
- Соберите из двух исследований одну «книгу продаж» и нарезайте материалы уже из неё.
- Готовый черновик прогоните через три фильтра из блока ниже — до того, как покажете его клиенту.
Проверка черновика тремя ролями
Когда пользоваться: Перед тем как показать презентацию или КП клиенту — чтобы найти слабые места до живых людей
Ниже черновик [презентации / КП / лендинга]. Прочитай его три раза, каждый раз от новой роли, и отвечай по каждой отдельно.
- Ты потенциальный клиент, который ничего о нас не знает. Что непонятно? На каком месте ты бы закрыл файл?
- Ты профессионал в нише [ваша ниша]. Где слабо? Какие утверждения не выдерживают проверки?
- Ты дизайнер. Где визуально проседает? Что бы ты поменял в первую очередь?
В конце сведи всё в пять правок по убыванию важности.
Черновик: [вставьте текст или приложите файл]
Ниже черновик [презентации / КП / лендинга]. Прочитай его три раза, каждый раз от новой роли, и отвечай по каждой отдельно.

1. Ты потенциальный клиент, который ничего о нас не знает.
   Что непонятно? На каком месте ты бы закрыл файл?

2. Ты профессионал в нише [ваша ниша].
   Где слабо? Какие утверждения не выдерживают проверки?

3. Ты дизайнер.
   Где визуально проседает? Что бы ты поменял в первую очередь?

В конце сведи всё в пять правок по убыванию важности.

Черновик: [вставьте текст или приложите файл]
Разобрать с ИИ
Готовый промпт со ссылкой на материал: пересказ, главные выводы и как применить к вашей задаче.
Посмотреть промпт
Вам может быть интересно
 $500 тыс.Billow AI LabsОбещание и счёт должны жить на одном этажеСтартап из Y Combinator встал на место бухгалтерской фирмы. Что из этого перенести в свою услугу
 Бэкапы по правилу 3-2-1-1-0: что я понял, когда упал БегетРазбор по горячим следам атаки на Бегет 2 ноября 2026: что такое настоящая резервная копия и что у меня уцелело. Отдельно — путь для тех, у кого сайт делал подрядчик, и для тех, кто работает с агентом
 GitHub с нуля: что это такое и как подключить его к ИИ-агентуДля тех, кто работает с Codex или Claude Code и ни разу не открывал GitHub: восемь понятий, регистрация и один запрос (после него агент сам сделает приватную копию вашей папки). Для тех, у кого есть подрядчик или команда, — правила доступа
 Как найти дело своей жизни: шесть физических шагов вместо поиска предназначенияМоя методика без эзотерики: цепочка из шести действий, воронка из 300 проб, диагностика «пропавшей страсти» и как начать на этом зарабатывать
 Как научить агента собирать комментарии с YouTube каждый деньПошагово: ключ YouTube Data API за 15 минут, промпт для Claude Code или Codex, расчёт квоты и правила, о которых агент обычно не предупреждает
 Claude Code: как пользоваться агентом, который сам работает с вашими файламиУстановка, первая сессия, режимы разрешений, CLAUDE.md и AGENTS.md, навыки, субагенты, хуки и MCP — и честное сравнение с Codex. Всё сверено с документацией на 27 октября 2026
 Как писать промпты для нейросетей: постановка задачи вместо заклинанийИз чего состоит хороший промпт, какие старые приёмы пора выбросить, примеры «было → стало» и готовые промпты для копирования
 Нейросети для работы: хватит одной-двух, если знать, что им поручатьСемь ассистентов на октябрь 2026 года: что каждый делает лучше, что бесплатно, что работает из России. Карта «задача → инструмент» по профессиям, 152-ФЗ коротко, план первой недели и рабочие промпты
 ТЗ для нейросети: каша в голове даёт кашу на выходеШесть шагов от идеи до описания продукта, по которому нейросеть или разработчик собирают нужное с первого-второго захода: промпты на каждый шаг, сквозной пример и проверка ТЗ
 Как учиться с помощью нейросети: сначала задача, знания — по ходуВайб-лёрнинг на практике: когда спрашивать нейросеть, как сформулировать вопрос, четыре промпта-тренера, учебные режимы ChatGPT, Claude и Gemini и пять ошибок, из-за которых обучение буксует